


QA карточки товара — это проверка не красоты текста, а согласованности всех представлений одного продукта. Заголовок, характеристики, описание, изображение, цена, наличие, фид и structured data должны описывать один и тот же SKU и соответствовать правилам канала.
Проверки строятся слоями: схема и обязательность полей, фактическая согласованность, редакционные правила, технический экспорт и контроль уже опубликованной страницы. AI полезен для семантических несоответствий и приоритизации риска, но критические факты проверяются детерминированно по мастер-данным.

Путь карточки до публикации
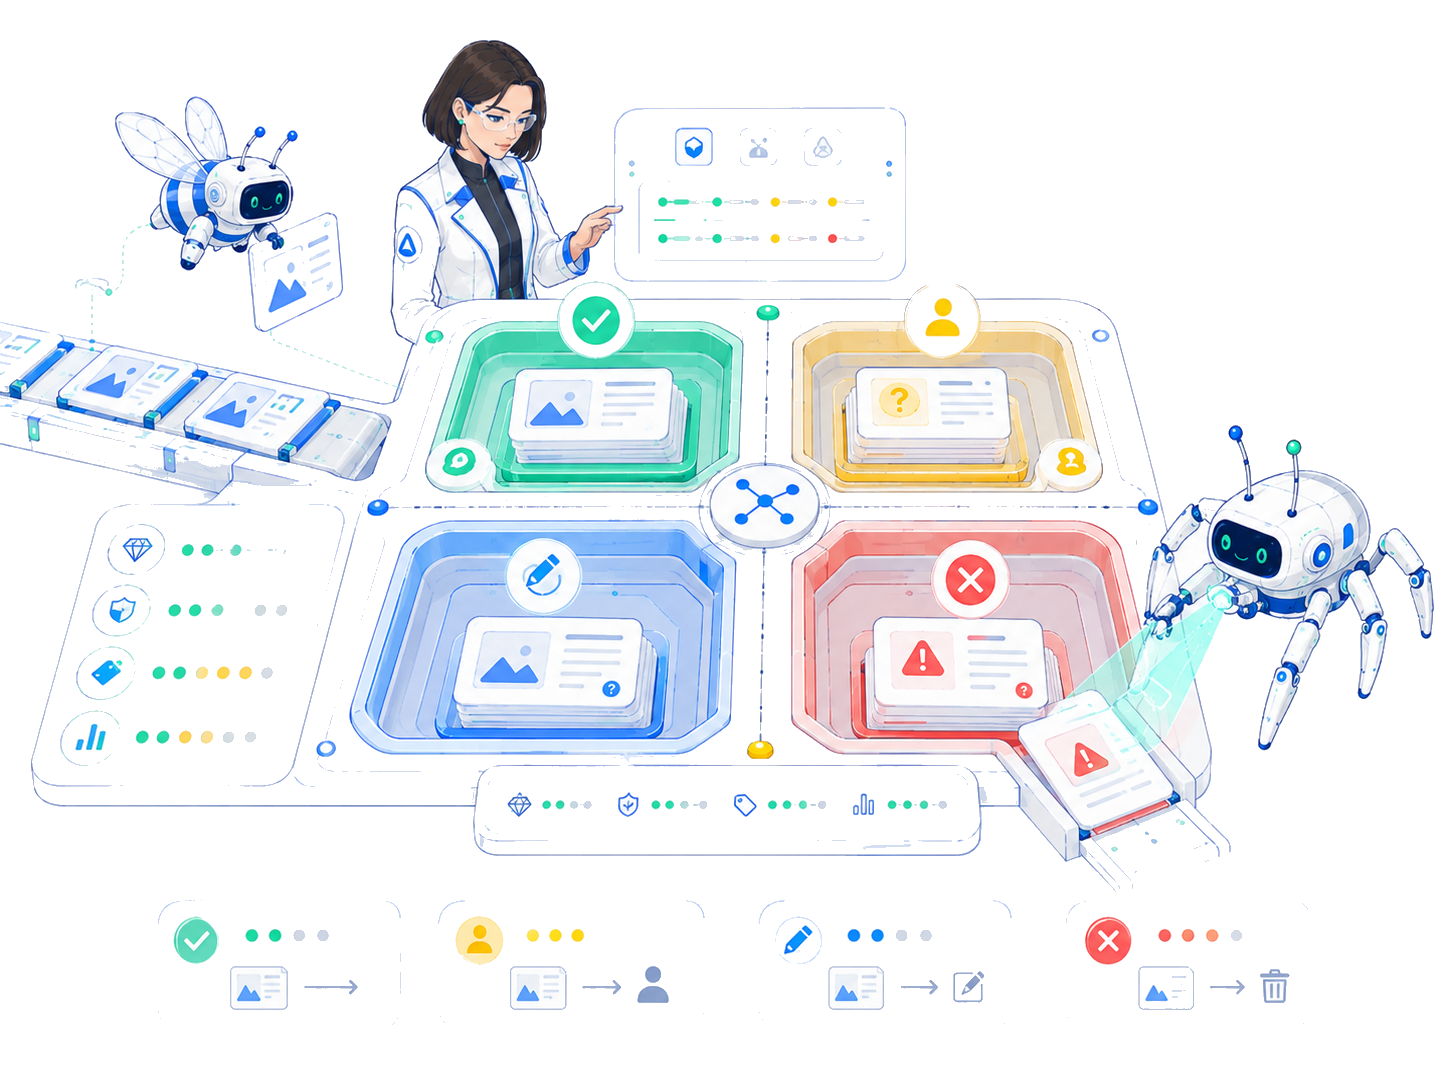
После подготовки версии карточки система формирует immutable snapshot входных данных. Валидаторы проверяют идентификаторы, категорию, GTIN/бренд при необходимости, единицы измерения, цену, доступность и набор изображений. Затем сравниваются факты в структурированных полях и свободном тексте.
Нарушения получают код, серьёзность и владельца. Блокирующая ошибка запрещает публикацию, предупреждение допускает решение редактора, а информационный сигнал идёт в отчёт. После публикации мониторинг сверяет фактическую страницу и ответ площадки с утверждённой версией.

Что должно быть готово до запуска потока
Реестр правил начинается с реальных дефектов. Для каждого типа ошибки фиксируются пример, цена последствий, метод обнаружения, владелец исправления и допустимое исключение.
Такое описание не даёт команде бесконечно добавлять косметические проверки, которые увеличивают очередь, но не защищают покупателя или канал.
Семантический валидатор должен возвращать evidence. Вместо «описание подозрительное» он указывает конкретное утверждение и конфликтующее поле мастер-данных.
Редактор видит оба фрагмента и принимает решение. Подтверждённая ошибка становится тестом, а допустимое исключение — правилом с областью действия и сроком пересмотра.
Выборочная проверка строится по риску. Новая категория, новый шаблон, дорогой товар, высокая доля возвратов или существенное изменение источника повышают вероятность ручного контроля.
Стабильный сегмент с хорошей историей можно проверять реже, сохраняя случайную контрольную долю для обнаружения незаметного дрейфа.
Практический кейс на масштабе · Akeneo / Unifai. Akeneo/Unifai автоматизирует нормализацию product attributes — размеры, вес, цвета и другие поля — под конкретные требования marketplace, после чего структурированный результат интегрируется в PIM. Компания подчёркивает цель получить listing, который одновременно полный, надёжный и адаптирован под требования площадки. Что здесь можно забрать в поток: это хороший QA-паттерн для карточек: проверять нужно не «нравится ли текст», а соответствие обязательной схеме, атрибутам, marketplace-rules и данным из master source. Источник: Google Cloud ↗
Правила для потока, а не одной карточки
- Проверяем snapshot. QA относится к конкретной версии входов и результата; изменившиеся данные требуют новой проверки.
- Severity вместо общего балла. Одна критическая ошибка важнее десятка косметических замечаний.
- Факты детерминированы. Цена, валюта, наличие, идентификаторы и размеры сверяются кодом, а не языковой моделью.
- Семантика с evidence. AI указывает конфликт и поля-основания, чтобы редактор мог подтвердить решение.
- После публикации тоже есть QA. Доставка, кеш и трансформация канала могут исказить корректный исходный пакет.
Где мастер-данные, генерация и публикация
Rule engine отвечает за схему, регулярные выражения, диапазоны и связность полей. Семантический валидатор ищет противоречия между описанием, атрибутами и изображениями. Policy layer хранит правила бренда и площадок с датами действия.
Очередь ревью сортируется по серьёзности, обороту категории, новизне шаблона и неопределённости проверки. Решение редактора записывается как отдельное событие: кто, когда, почему и какое исключение одобрил. Это позволяет отличать реальный дефект от допустимого отклонения.
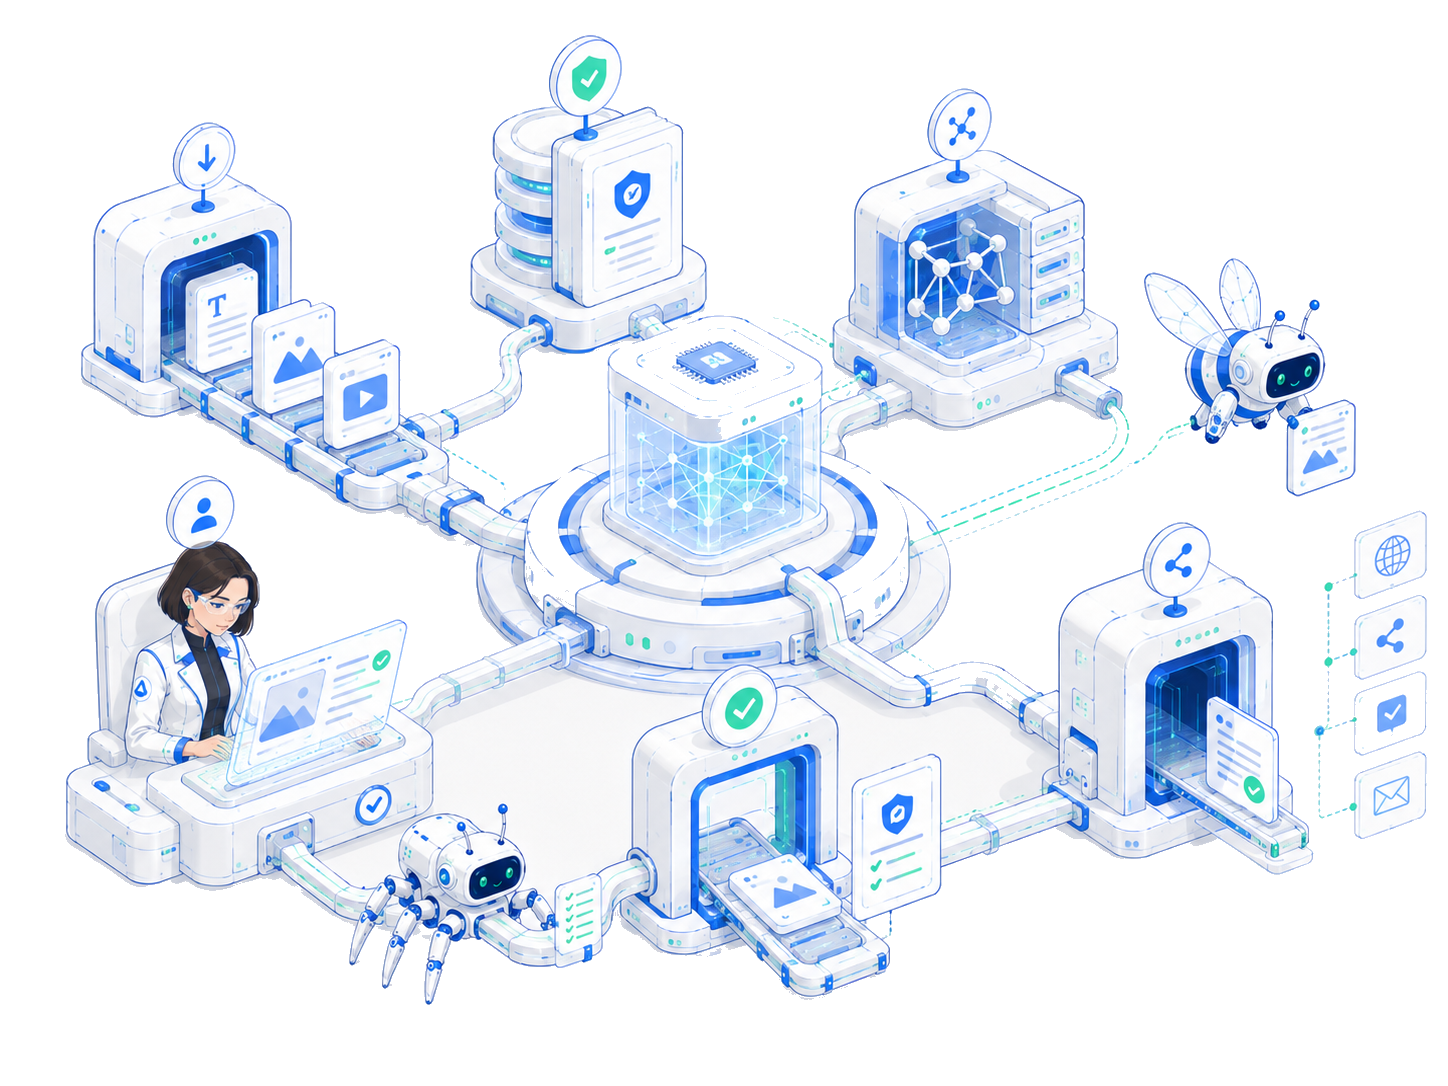
Где ставить QA
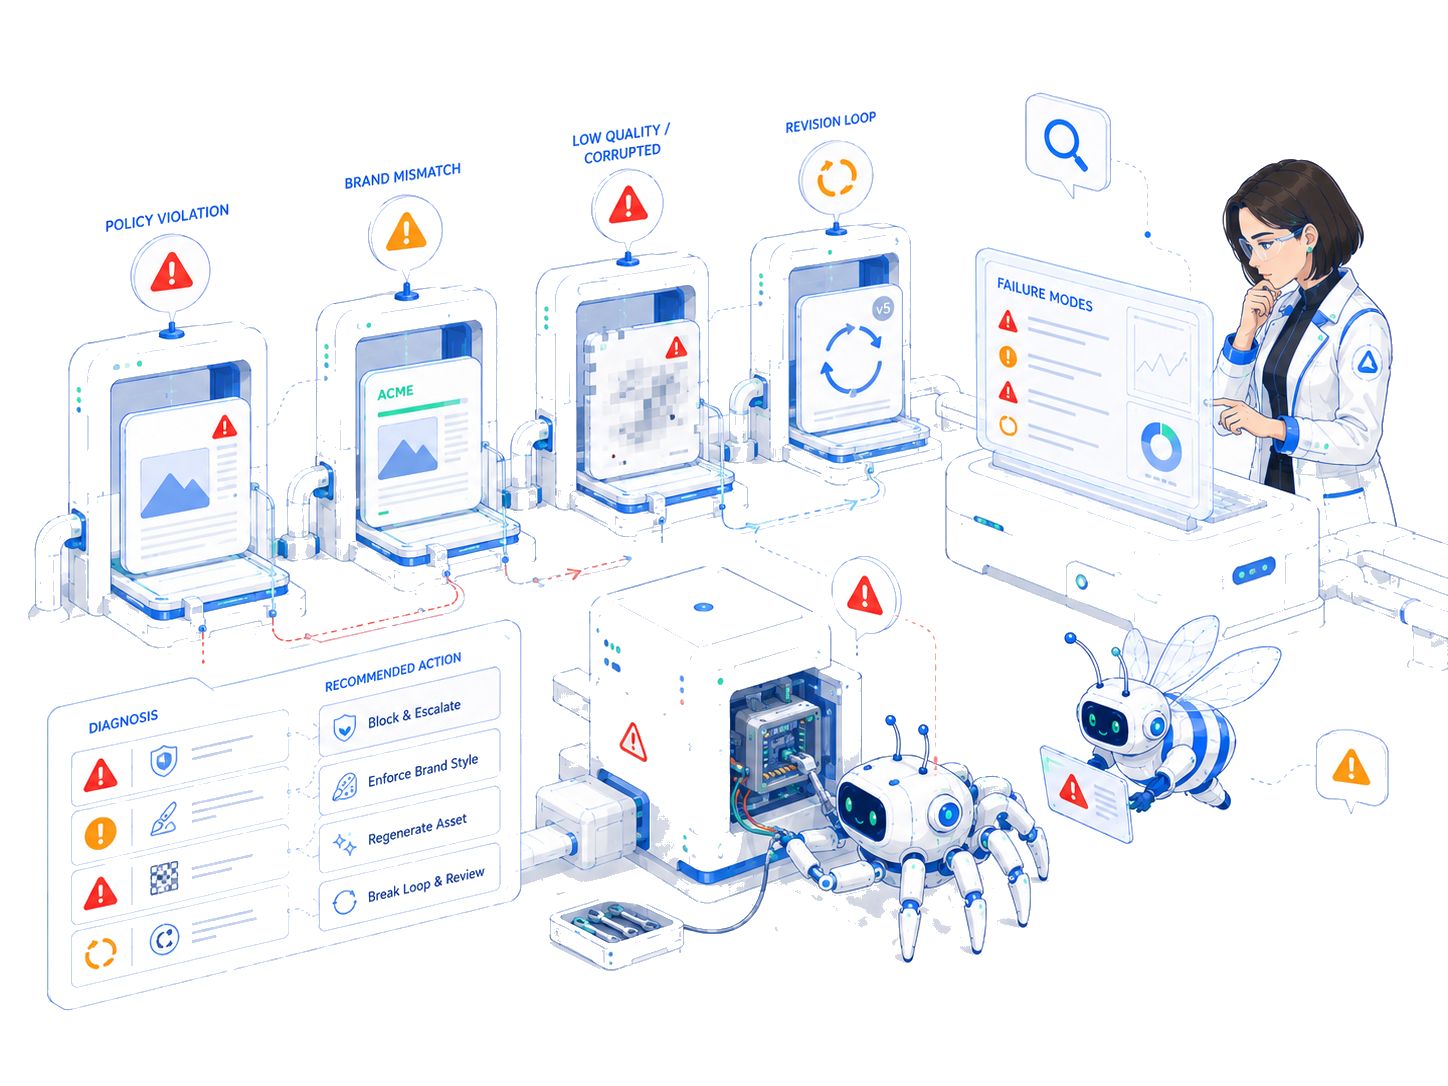
Для потока правило такое: риск нужно связывать с наблюдаемым сигналом и заранее определённым действием. Для потока правило такое: наблюдаемый сигнал заранее связываем с действием, чтобы после инцидента команда не угадывала причину вручную.
| Риск | Как проявляется | Контроль |
|---|---|---|
| Ложное чувство качества | Средний score высокий, но есть критическая ошибка цены | Блокирующие правила вне агрегированного балла |
| Разъезд вариантов | Изображение и текст относятся к разным цветам | Проверка parent/variant связей и media mapping |
| Устаревшая политика | Правило площадки изменилось | Версии, дата проверки и регулярная ревизия источников |
| Автоматическое исправление факта | Система меняет значение без подтверждения | Предлагать patch, но применять через владельца master data |
| Нет контроля доставки | Экспорт принят, но страница отображает другое | Post-publish crawl/API check и сверка полей |
Как я измеряю здоровье каталога
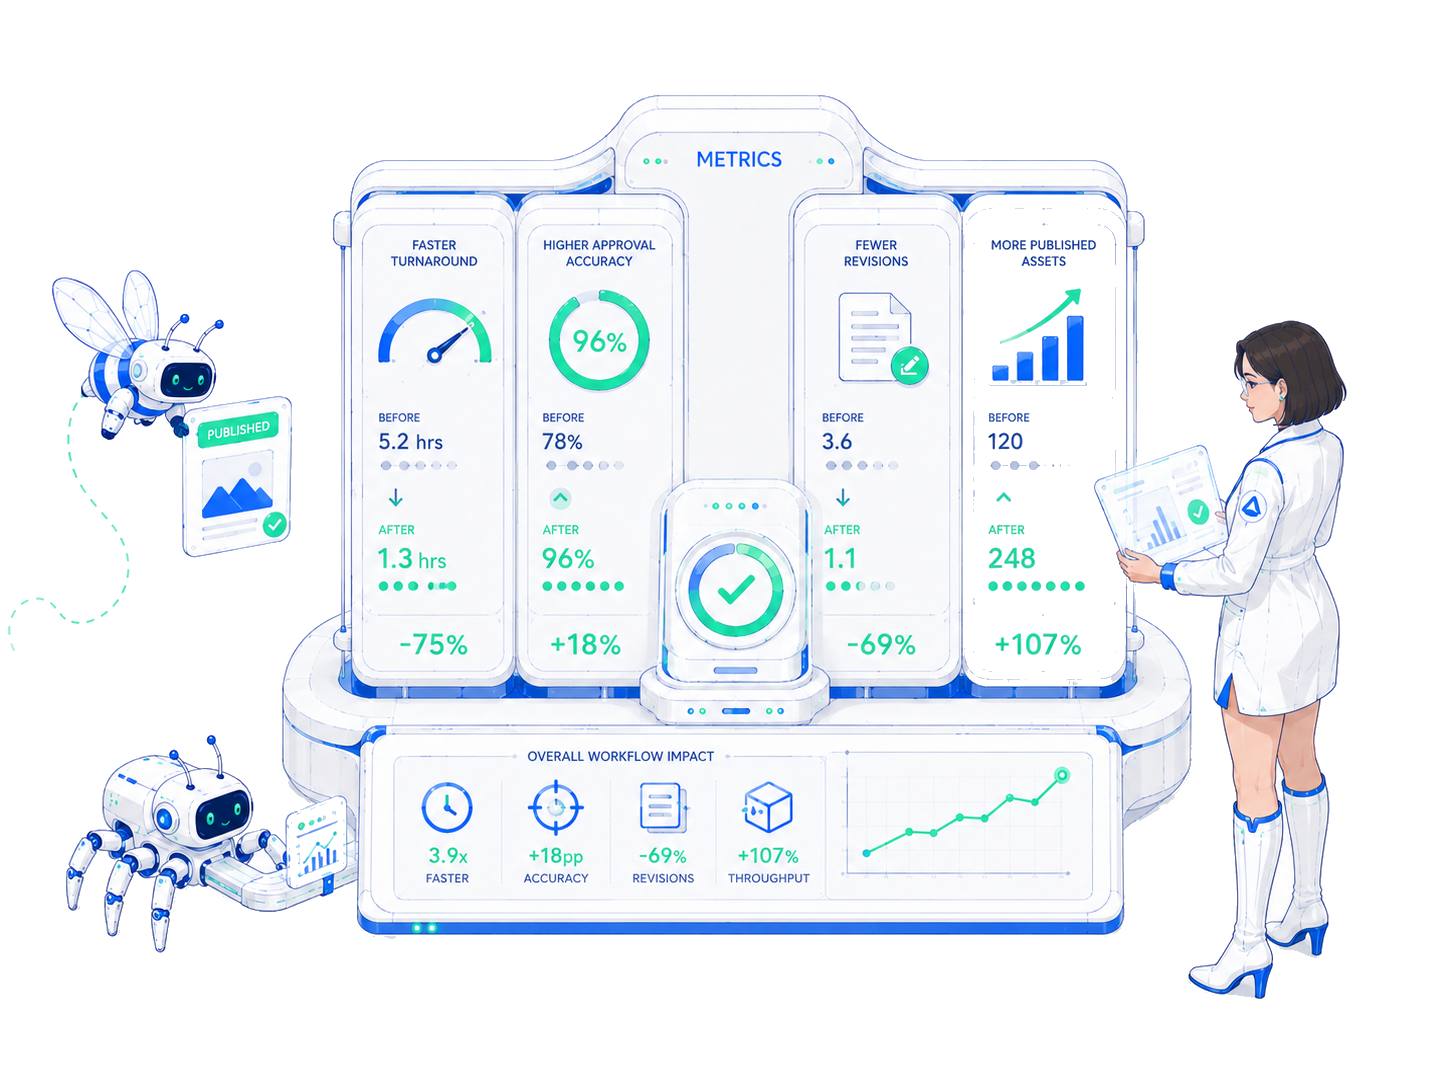
Для потока правило такое: перед первой партией я снимаю baseline потока. Для потока правило такое: считаем метрики по завершённому бизнес-результату и отдельно по сценарию, версии и причине исключения. Одно среднее скрывает деградацию.
| Метрика | Что показывает | Как разрезать |
|---|---|---|
| Escape rate | дефекты, найденные после публикации | по severity и каналу |
| False positive rate | отклонённые редактором сигналы QA | по правилу и версии |
| First-pass yield | доля карточек, прошедших без возврата | по категории |
| Время исправления | от обнаружения до принятой версии | по владельцу и severity |
| Доля post-publish drift | расхождения после доставки | по полю и интеграции |
С какой части каталога я бы начала
- 01
Составить реестр дефектов и определить блокирующую серьёзность.
- 02
Связать каждое правило с источником данных и владельцем исправления.
- 03
Реализовать детерминированные проверки схемы и фактов.
- 04
Добавить семантический слой на контрольной выборке.
- 05
Настроить очередь ревью и протокол исключений.
- 06
Замкнуть цикл post-publish проверкой и отчётом по escape rate.
Готов ли поток к следующей тысяче SKU
Для потока правило такое: перед включением реального потока команда проходит короткий операционный чек-лист. Для потока правило такое: считаем пункт закрытым только когда есть проверяемый артефакт: настройка, тест, журнал или назначенный ответственный.
- Каждое правило имеет severity и владельца
- Блокирующая ошибка не растворяется в среднем score
- Семантический сигнал содержит конфликтующие evidence
- Исключение ограничено областью и сроком действия
- Ручная выборка зависит от риска и включает случайный контроль
- После публикации сверяются страница, фид и structured data
Что обычно всплывает на масштабе
Можно ли заменить редактора AI-проверкой?
AI сокращает объём ручной работы, но спорные заявления, исключения и высокая цена ошибки требуют ответственного решения человека.
Нужен ли один QA-score?
Он удобен для сортировки, но не должен скрывать блокирующие ошибки. Храните severity и причины отдельно.
Что проверять после публикации?
Доступность страницы, цену, наличие, выбранный вариант, изображения, structured data и статус приёма канала.
Что я бы поставила в поток первым
Для потока правило такое: на диагностике я фиксирую узкое место, данные, ручную нагрузку, QA и реалистичную первую партию.
На что я опираюсь по площадкам и данным
- Product data specificationGoogle Merchant Center
- Introduction to Product structured dataGoogle Search Central
- Product detail attributeGoogle Merchant Center
- Set up structured data for Merchant CenterGoogle Merchant Center
- ProductSchema.org
- OfferSchema.org
- GS1 Data Quality Framework for Brand OwnersGS1
- Merchant Center product data specification update 2024Google Merchant Center
Источники и методическая база
- Product data specificationGoogle Merchant Center
- Introduction to Product structured dataGoogle Search Central
- Product detail attributeGoogle Merchant Center
- Set up structured data for Merchant CenterGoogle Merchant Center
- ProductSchema.org
- OfferSchema.org
- GS1 Data Quality Framework for Brand OwnersGS1
- Merchant Center product data specification update 2024Google Merchant Center
- Akeneo Case StudyGoogle Cloud


